새 모델이 나오면 표가 하나 따라옵니다. 코딩 점수, 에이전트 점수, 추론 점수. 바이브 코딩에 쓸 모델을 고를 때도 결국 이 표를 봅니다.
그런데 표의 숫자를 나란히 놓으면 이상한 일이 생깁니다. 어떤 모델은 66.7점이고, 어떤 모델은 28.6점이고, 또 어떤 모델은 74.9%입니다. 앞의 모델이 뒤의 모델보다 두 배 잘하는 걸까요?
아닙니다. 재는 것이 다릅니다. 이번 글은 세 회사가 직접 공개한 수치를 놓고, 각 숫자가 무엇을 재는지부터 짚어 봤습니다.
같은 '코딩'이 아니다
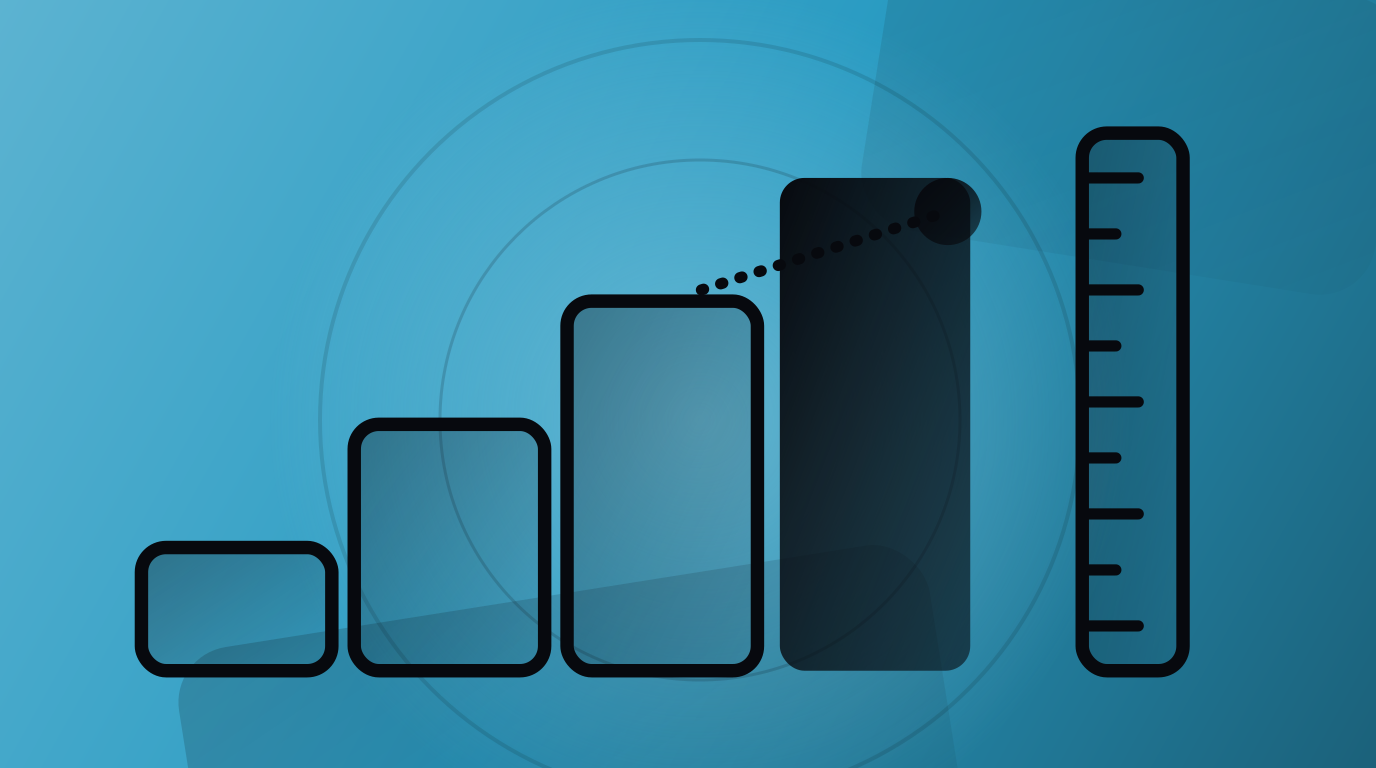
코딩 벤치마크는 문제의 크기가 다릅니다. 이 글에 나오는 것들을 작은 순서로 늘어놓으면 이렇습니다.
계단 왼쪽은 잘 정의된 문제 하나를 푸는 능력입니다. 오른쪽으로 갈수록 실제 저장소를 읽고, 명령을 여러 번 실행하고, 도구를 이어 쓰는 능력을 봅니다. 에이전트로 바이브 코딩을 할 때 실제로 필요한 건 오른쪽입니다.
OpenAI: SWE-bench를 고친 이유
SWE-bench는 실제 오픈소스 저장소의 이슈를 모델이 해결하게 하고, 숨겨진 테스트로 채점합니다. 저장소 단위라서 바이브 코딩과 가장 닮은 벤치마크로 자주 인용됩니다.
OpenAI가 쓰는 건 그중 SWE-bench Verified입니다. GPT-5 시스템 카드는 이를 사람이 검증한 하위 집합이라고 소개합니다. 원본에는 맞는 풀이를 틀렸다고 채점하거나, 문제 설명이 부족하거나, 단위 테스트가 지나치게 특정한 경우가 있었고, 검증 집합이 이를 바로잡았다는 설명입니다.
측정 조건도 적혀 있습니다.
- 모든 실행에 OpenAI 내부 인프라에서 검증한 고정된 477문항을 씁니다.
- 모델에게는 bash 명령과
apply_patch도구를 줍니다. - 지표는 pass@1이고, 문항마다 4번 시도한 평균입니다.
- 모델은 채점용 단위 테스트를 보지 못합니다.
같은 문서에 흥미로운 주석이 하나 있습니다. GPT-5 출시 블로그의 SWE-bench 74.9%는 기본 '장황도' 설정으로 잰 값이고, 시스템 카드의 평가는 최대 장황도로 쟀기 때문에 결과가 달라질 수 있다는 것입니다.
같은 회사의 같은 모델도 설정에 따라 숫자가 바뀝니다. 다른 회사의 숫자와 바로 비교하면 안 되는 이유가 여기 있습니다.
LG AI연구원: EXAONE 4.0의 66.7
LG AI연구원은 2025년 7월 EXAONE 4.0을 공개하며 코딩 지표로 LiveCodeBench v6 66.7을 제시했습니다. 전문가용 32B와 온디바이스용 1.2B 두 크기이고, MCP와 함수 호출을 지원한다고 밝혔습니다. 언어는 한국어와 영어에 스페인어가 더해졌습니다.
LiveCodeBench는 계단의 가장 왼쪽, 문제 하나를 코드로 푸는 쪽에 가깝습니다. 그래서 66.7이라는 숫자는 "알고리즘 문제를 얼마나 잘 푸나"에 대한 답으로 읽는 게 맞습니다. 저장소를 다루는 능력은 이 숫자만으로는 알 수 없습니다.
대신 MCP와 함수 호출 지원은 다른 질문에 답합니다. 이 모델을 에이전트의 두뇌로 꽂을 수 있느냐는 질문입니다. 점수표만큼 지원 기능 목록도 봐야 하는 이유입니다.
업스테이지: 두 배가 됐다는 말의 뜻
업스테이지는 2026년 3월 Solar Pro 3 업데이트를 발표하며 에이전트 성능이 약 두 배가 됐다고 밝혔습니다. 숫자는 Solar Pro 2 대비 이렇습니다.
| 벤치마크 | Solar Pro 2 | Solar Pro 3 |
|---|---|---|
| Tau2-all (에이전트) | 36.0 | 72.3 |
| SWE Bench (코드 에이전트) | 14.5 | 28.6 |
| Terminal Bench 2 | 2.2 | 10.1 |
이 표를 읽는 방법은 두 가지입니다. 같은 회사의 이전 모델과 비교하는 데는 좋은 표입니다. 같은 회사가 같은 방식으로 쟀기 때문입니다. 업스테이지는 각 벤치마크의 공식 평가 절차를 따랐다고 밝혔습니다.
반면 절대값은 신중하게 봐야 합니다. SWE Bench 28.6과 Terminal Bench 2 10.1은 개선 뒤에도 높은 숫자가 아닙니다. 계단 오른쪽이 그만큼 어렵다는 뜻이기도 합니다.
발표문에서 눈에 띄는 건 개선의 동기입니다. 운영 환경에서는 도구 호출 하나하나는 성공하는데 전체 흐름이 실패하는 문제가 있고, 이번 개선이 그 문제를 겨냥했다고 적혀 있습니다. 바이브 코딩을 해 본 사람이 겪는 "부분은 맞는데 전체는 안 돌아가는" 상황을 모델 쪽에서 설명한 문장입니다.
표를 볼 때 세 가지만
세 회사의 자료를 나란히 읽고 나면 체크리스트가 남습니다.
- 어느 계단인가. 문제 하나인지, 저장소인지, 터미널인지, 다중 턴 도구 사용인지 먼저 봅니다. 계단이 다르면 숫자를 비교하지 않습니다.
- 누가, 어떻게 쟀나. 문항 수(전체인지 고정 하위 집합인지), 시도 횟수, 쓸 수 있는 도구, 설정값이 다르면 같은 벤치마크라도 다른 숫자가 나옵니다.
- 우리 일과 닮았나. 결국 가장 믿을 만한 벤치마크는 우리 저장소에서 우리 이슈로 해 보는 것입니다. 이 블로그의 검색 평가 글에서 시험지를 직접 만든 것도 같은 이유였습니다.
벤치마크 점수는 모델을 걸러 내는 첫 체로는 쓸 만합니다. 마지막 결정은 우리 코드 앞에서 내려야 합니다.